

全球首件丹尼索瓦人下肢骨現於臺灣海峽:澎湖腿骨化石身高或近1.9公尺
2026年8月20日
行業新聞:古DNA與同位素證據揭示中國北方粟作農業的「第三種路徑」
2026年8月22日OpenZupu:用開源程式碼「復活」豎排族譜的開源家譜平台
2026年7月的 OpenAI Build Week 黑客松(7月13—21日)上,一個名為 OpenZupu(開元族譜)的開源項目引發家譜數位化社群關注。這個由開發者 Joan Kuo 提交的項目,目標直指中國族譜傳承的深層痛點:用開源程式碼建構一個能真正讀懂豎排文言文族譜、連接地理遷徙與遺傳譜系的數位化平台,並已透過 Devpost 向公眾發布完整的技術說明與示範。
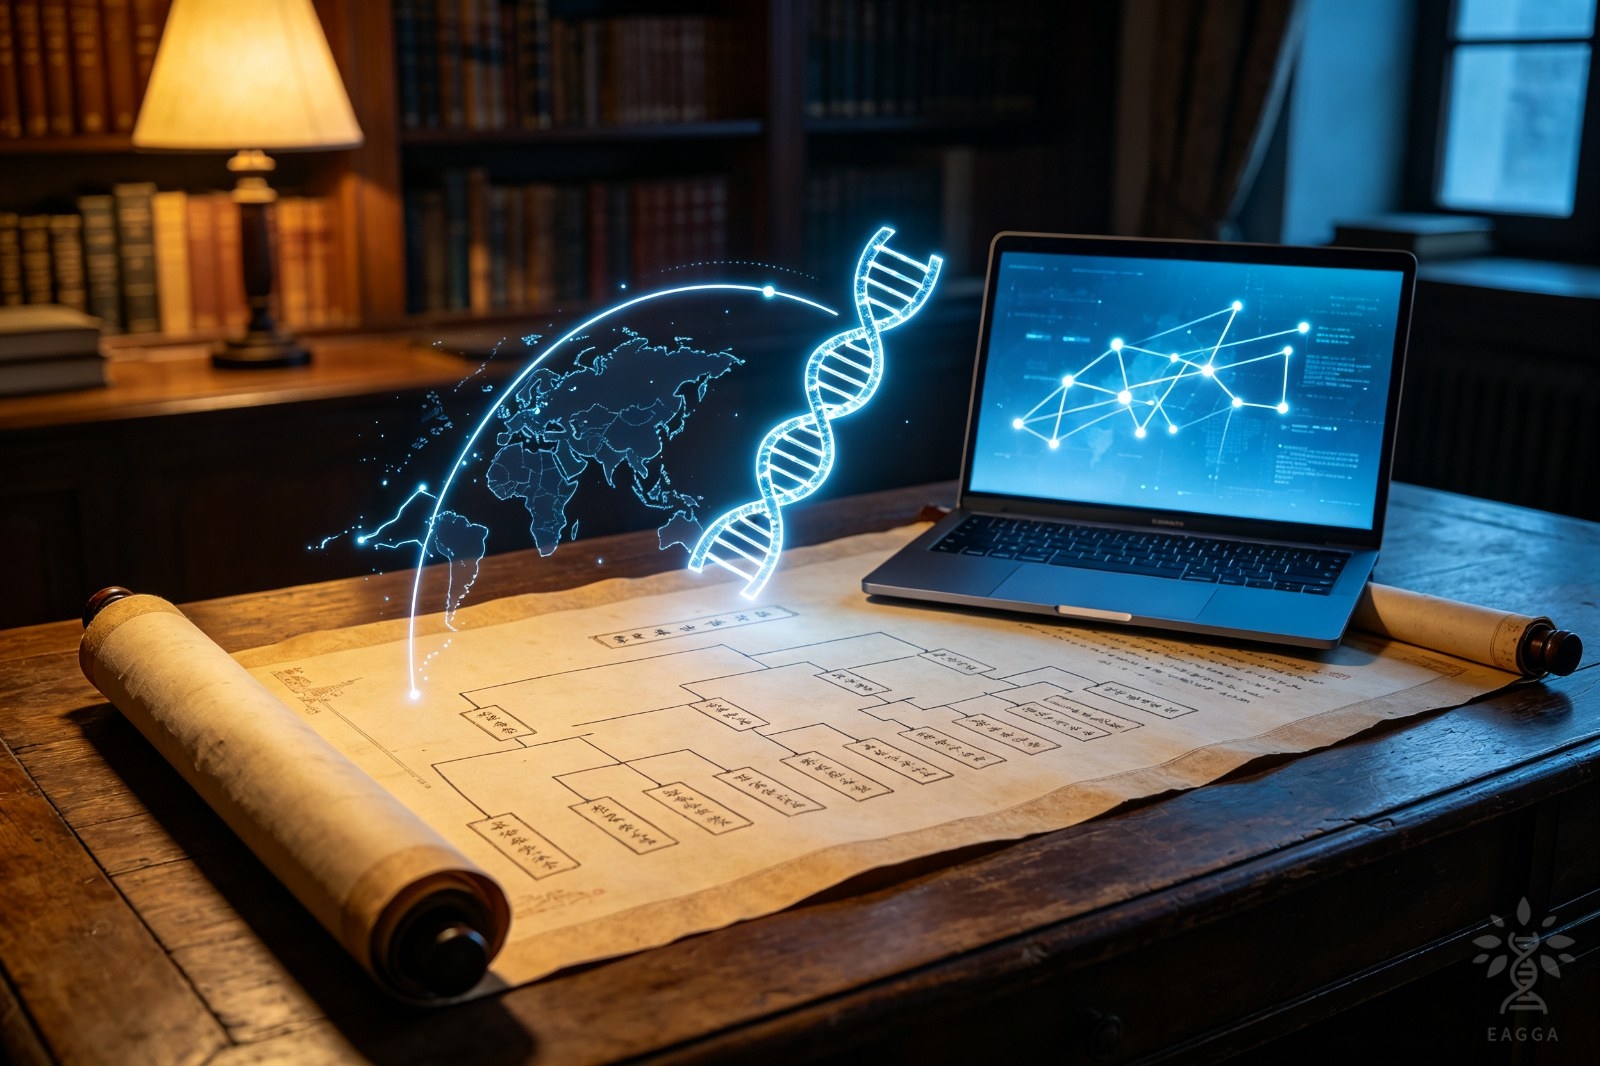
項目的靈感來自對傳統族譜處境的觀察:兩千多年來,中國家庭以紙質族譜(族譜/家譜)保存家族傳承,但這些實體冊頁極度脆弱——時間、戰亂與環境損耗都可能讓百年世系化為烏有;更重要的是,族譜以高度簡省的文言文寫成,採用傳統豎排右起版式,並包含複雜的長幼排行與輩字(昭穆)系統,年輕一代幾乎難以解讀。
OpenZupu 的功能設計涵蓋了族譜數位化的全鏈條。其一,互動式多風格譜系圖:可動態生成蘇式世系樹(豎列式直系父系譜圖)與歐式譜文(供印刷與存檔的密集豎排文本),同時支援西式後代/祖先圖與扇形圖;其二,時空地理定位時間線與地圖:從出生地、居住地與墓葬記錄中提取資訊,在地圖上呈現數百年的家族遷徙軌跡;其三,遺傳譜系映射:將父系 Y-STR/Y-SNP 與母系 mtDNA 突變單倍群映射到家族各分支,支援聯邦式查詢並計算最近共同祖先(MRCA);其四,自動化譜系完整性校驗:透過規則引擎識別生物異常,如子女代年齡大於父母、代際空缺、排行輩字不匹配等;其五,通用可攜性:無縫匯入匯出標準 GEDCOM(.ged)、GraphML、CSV 與 JSON 備份。
在技術實現上,OpenZupu 採用解耦的單倉庫架構:前端以 Next.js、React、TypeScript 建構,使用自訂 Tailwind CSS,並融入古羊皮紙紋理、思源宋體等傳統視覺元素;後端由 NestJS 提供 RESTful 介面,配以 JWT 認證、自訂守衛與交易層級稽核日誌;資料庫層採用 PostgreSQL 與 Prisma ORM;OCR 環節使用 Tesseract.js(chi_tra 繁體中文模型)非同步處理掃描檔案的文本提取。整個系統可透過 Docker Compose 輕鬆自架設,無需依賴昂貴的商業 SaaS。
開發團隊坦言了最具挑戰性的部分:在 Next.js 中渲染傳統中文豎排版式(writing-mode: vertical-rl)時,無限列印畫布曾出現嚴重的橫向文字裁切、列重疊與列印缺失,最終透過將動態列寬控制在160—400像素之間並重寫列印 CSS 解決;預渲染與用戶端導航的水合衝突,則透過將導航鉤子封裝在用戶端邊界內化解。
項目也拿出了幾個值得驕傲的成果:為蘇式、歐式豎排圖編譯生成可完美列印的 SVG 向量圖;實現帶 UTF-8 BOM 的 Excel 相容 CSV 匯出,徹底解決傳統漢字亂碼問題;產出一套可直接生產的 Next.js + NestJS 程式碼庫,任何地方宗族理事會都可自行部署。
OpenZupu 的路線圖同樣面向未來:團隊計畫深度整合 OpenAI GPT-4o 的視覺與結構化輸出能力——使用者上傳豎排手寫族譜照片後,AI 可直接轉錄、切分人名並輸出結構化 JSON/GEDCOM 譜系樹;將高度簡省的文言文傳記翻譯為現代可讀的敘述;並提供語意檢索副駕(RAG),讓使用者直接提問如「我們家族哪一支在明末遷往福建」。
對遺傳譜系研究者而言,OpenZupu 的獨特價值在於它把傳統譜牒與分子證據放進了同一個平台:族譜文本提供世系框架,地理時間線還原遷徙,Y-DNA 與 mtDNA 單倍群則提供血緣印證,三者協同可以顯著提升家譜的可信度與可解釋性。這也與當下多模態家譜檔案的學術方向不謀而合——文本、空間與基因正在走向同一張家族網絡。
作為開源項目,OpenZupu 的選擇具有方法論意義:當族譜數據事關家族隱私與自主權,「自架設、隱私優先」的路線讓宗族組織不必把核心家譜數據託付給商業平台。項目已在 GitHub(github.com/yuancafe/openZupu)開放原始碼並提供線上示範。從紙質族譜到開源數位譜系,中國家族記憶的保存方式正在迎來新的可能。